
搜索到
172
篇与
软件类
的结果
-
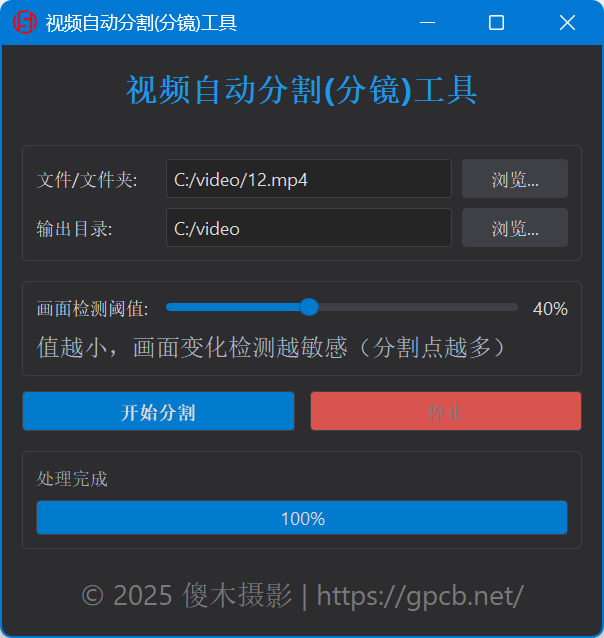
 视频自动分割分镜工具 视频自动分割分镜工具这是一款名为“视频自动分割(分镜)工具”的桌面应用程序,基于 Python 和 PyQt5 开发。核心功能自动分割:通过检测画面变化,自动分割视频文件或文件夹中的视频片段。直观界面:具备图形用户界面(GUI),操作简单。高度自定义:支持多种视频格式,提供画面检测阈值设置,允许用户灵活调整检测敏感度。便捷操作:支持一键选择视频文件/文件夹、指定输出目录,并可在分割完成后一键打开结果目录。应用场景该工具适用于需要对视频进行快速自动分割的用户,本工具为后续视频自动卡点做辅助。工具特点✅ 无功能限制✅ 无广告✅ 无套路🎁 免费使用(用爱发电,欢迎打赏)下载地址下载链接:https://abpyu.lanzoul.com/i7REh2xk293a提取码:6b8q
-
-
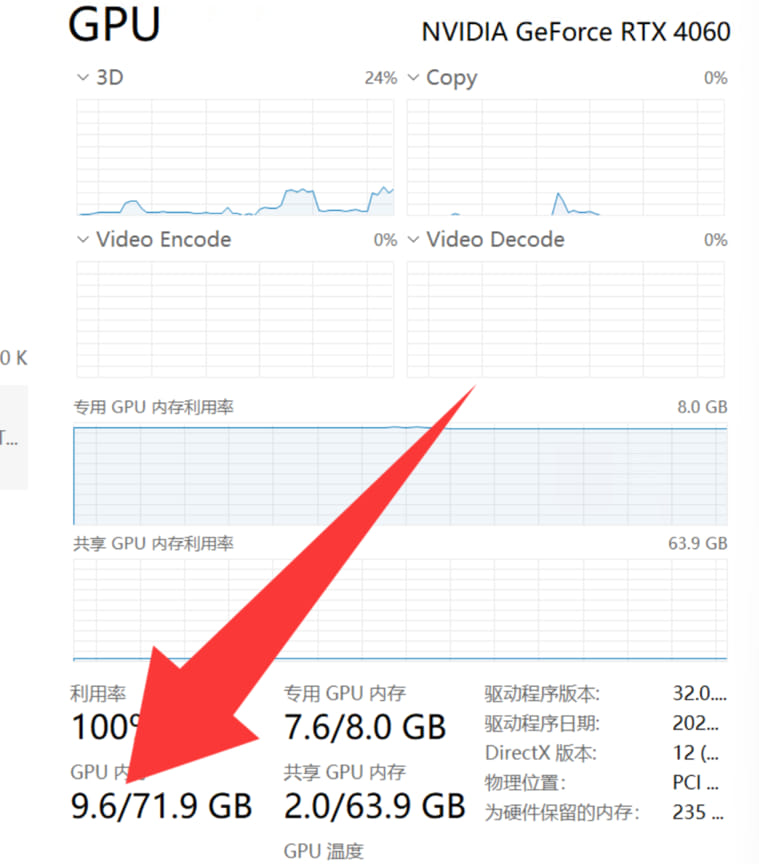
IndexTTS: 可控高效语音合成系统,一键懒人包,自媒体配音神器 IndexTTS: 可控高效语音合成系统,一键懒人包,自媒体配音神器之前测试过好几个类似的软件,都没有这个好。可以听听下面这段音频,停顿以及语气,是不是与原装无异? window.jwplayer || document.write('')播放器载入中...jwplayer.defaults = {"base":"https://gpcb.net/usr/plugins/JWPlayer/player/"};jwplayer("jwplayer_1").setup({"file":"\/usr\/uploads\/2025\/05\/3994693910.mp3","autostart":"true","repeat":"true","preload":"auto","width":"800","height":"5","localization":{"rewind":"\u540e\u900010\u79d2","settings":"\u9009\u9879","cc":"\u5b57\u5e55","hd":"\u753b\u8d28","fullscreen":"\u5168\u5c4f","videoInfo":"\u67e5\u770b\u5a92\u4f53\u4fe1\u606f","copied":"\u590d\u5236\u6210\u529f","playlist":"\u5217\u8868","nextUp":"\u4e0b\u4e00\u4e2a","liveBroadcast":"\u5728\u7ebf\u76f4\u64ad"}});(默认是静音的,点下喇叭图标开启)💡 使用须知本站发布的软件使用起来都是极其简单,饭盛碗里递你手上了,筷子递你手上了,不提供喂饭服务。不会用也不用留言问,请自己琢磨研究。实在不会用,请删除。看见官方有更新的,也不用催更,只做我想做的。本站是我私人的自留地,我所说的都是我想说的,合法且不会触及我的道德底线。如果触及了你的心理防线,我建议你将这条线拉高一点。如果你是我同事,看见了你不想看见的内容,请你装作没看见,也不用给我留言。这是我唯一可以肆无忌惮倾诉的地方,请给我留一条活路!📦 版本说明与优化更新地址: https://www.jian27.com/html/624.html (jian27打包)在本站的打包基础上,进行了以下“负优化”与改进:体积瘦身:减少了体积,压缩包原先 4.6GB,优化后为 4.2GB。格式转换:原先输出 wav 音频格式,已改为 MP3。目录简化:简化了目录结构,解决了原先目录较乱的问题。⚙️ 性能与效率说明本工具如果用来转换大段文本,效率是比其他软件低很多的:原因:本软件拆字断句与其他软件截然不同,几乎是逐字拆句的。优势:好在最终效果比其他软件输出的效果更好。参考数据:千字左右段落约需要 4 分钟左右。占用显存约 7GB 左右。📥 下载地址百度网盘(回复后刷新可见)隐藏内容,请前往内页查看详情
-
DeepSeek本地部署一键运行DeepSeek-tool v10+Qwen3-30B-A3B DeepSeek本地部署一键运行DeepSeek-tool v10+Qwen3-30B-A3BQwen3前几天发布了,群里打包了懒人包。升级了llama,我替换了模型。硬件与模型配置内置模型:只有一个 Qwen3-30B-A3B显存要求:需要 12GB 黄皮显卡低配方案:少于 12GB 的可以下载 jian27 版本账号信息默认的管理员账号如下,进去后请自行修改:账号 1:jian27@126.com账号 2:123@123.com密码:1234转载自jian27下载地址百度网盘下载链接(回复后刷新可见,大小 11.95GB):隐藏内容,请前往内页查看详情
-
Spark-TTS,极简版音频克隆 Spark-TTS:极简版音频克隆核心功能如果你是播客主,或者经常在 B 站发布视频解说,可以使用这款工具:音色克隆:录制一段你说话的录音,即可用你的音色生成任意文本的音频。趣味应用:你可以让“猪八戒”给你讲故事,实现极具个性化的语音输出。使用方法非常简单:上传一段参考音频或者录制你自己的声音。输入你想转换成音频的文本。点击开始克隆即可。技术原理与优势Spark-TTS 是一款先进的文本转语音(Text-to-Speech,TTS)系统,它利用大型语言模型(Large Language Model,LLM)的强大功能,实现了高度准确且自然流畅的语音合成。该系统旨在为研究和生产使用提供高效、灵活且强大的解决方案。简洁与高效:完全基于 Qwen2.5 构建,无需额外的生成模型(如流匹配模型等)。通过直接从 LLM 预测的代码中重构音频,简化了流程,提高了效率并降低了复杂性。零样本语音克隆 (Zero-Shot Voice Cloning):支持在无需特定训练数据的情况下复制说话者的声音。这在跨语言和代码切换场景中尤为有用,允许在不同语言和声音之间无缝切换。多语言与个性化:支持中文和英文。通过调整性别、音调和语速等参数,可以创建虚拟说话者,提供个性化的语音合成体验。注意:Spark-TTS 主要用于学术研究、教育目的及合法应用(如辅助技术、语言学研究等)。用户应遵守法律法规,不得用于未经授权的冒充、欺诈、深度伪造或任何非法活动。版本优化说明下载地址: jian27打包我在 jian27 打包的基础上进行了“二次负优化”:瘦身减重:删减了不需要的 Web 界面及冗余文件(原包 5.99GB $\rightarrow$ 本站优化后 4.11GB)。Bug 修复:修复了原版文本输入框中含有“回车换行”时,仅能生成第一句的问题。本版本已支持回车不影响音频生成。性能优化:增加了显存回收功能。效果预期:音质大概能达到原音参考音频的 7 成左右。某些情况下转换出的音频语速会较快。硬件要求显卡:需要 NVIDIA 显卡(黄皮显卡)。显存:4GB 以上即可,推荐 6GB 以上。提示: 回复后刷新可以看见下载链接。隐藏内容,请前往内页查看详情
-
FunASR-webui,音频转成文本 FunASR-webui用于将音频转成文本,例如会议录音转成文字记录、mp4视频文件转换成字幕文件等等。运行说明操作流程:加载音频或者MP4文件点击开始按钮性能与输出:效率: 耗时视音频长度而不一,效率还是很高的。显存占用: 消耗显存约 2.5gb 左右。保存路径: 转换完成会在 out 目录自动保存为三个格式:一个 .txt 文件一个视频字幕文件一个音频歌词格式文件本站优化说明本站独家负优化:体积压缩: 显著减少体积,压缩包 3.2gb(原作 5.4gb)界面调整: web界面简化资源链接作者开源页面: https://github.com/gluttony-10/FunASR-webui视频教程(转载自 B站十字鱼): 点击观看百度网盘下载链接: (回复后刷新可见)隐藏内容,请前往内页查看详情
-
Deepseek本地部署(内置32B和14B模型)2月21更新 首次使用需要联网下载 install open-webui 组件(过程是自动的),之后就不用联网了。资源信息DeepSeek 本地部署:由剑二十七制作分享更新地址:https://www.jian27.com/html/1396.html (此版压缩包 40gb+)配套教程:DeepSeek从入门到精通.pdf本站独家“负优化”说明以下为本站针对显存优化的策略(优化后带两个模型总体积 14.4gb):1. 量化策略模型已替换为 Q2 量化版,显存占用大幅降低,6gb 以上黄皮显卡可玩。核心原则:在显存不够的情况下,优先选择“降低精度且模型体量大”的方案。例如:14b Q2 量化版,远比 8B fp16 效果好得多。在体量面前谈量化,那就是扯淡。2. 模型配置模型只保留了 14b 和 32b。显存占用参考:14b:实际运行占用约 5.5gb 显存。32b:实际运行占用约 11gb 显存。自定义替换:可以自己替换喜欢的模型,原则上 .gguf 后缀的模型都可以(例如某些无限制模型)。注:怎么替换请自行研究,不做解答。安装与使用指南1. 根目录优化刚刚更新的版本只是优化了根目录,看起来更简洁,更适合强迫症患者。2. 首次启动步骤开始使用:首次启动时,点击“开始使用”。账号设置:输入昵称(随便输)。默认管理员账号:jian27@126.com 或 123@123.com默认密码:1234进去后可自行修改。注意:这一步可能会白屏(浏览器什么都不显示),请耐心等待几秒钟。更新信息:3. 模型选择与设置根据你的电脑硬件情况选择模型:显存 < 8gb (N卡):建议选择 14b(最低要求 6gb 显存)。显存 > 12gb:可以跑 32b。详细设置:右上角有详细设置及账户设置等。联网搜索:可以设置联网搜索,但需要申请 API(属于各家搜索引擎收费项目,非本项目收费)。更多好玩的,请自己摸索。文件下载通过百度网盘分享的文件:DeepSeek-tool_V3.03.7z(回复后,刷新可见下载链接)下载链接:https://pan.baidu.com/s/1SaMyVC5Wn-yVdWXS3emM2Q?pwd=gpcb
-
Sonic,一键包,数字人工具,音频驱动图片说话,腾讯联合浙大开源 Sonic:腾讯联合浙大开源,一键包数字人工具关键词:Sonic, 一键包, 数字人工具, 音频驱动图片说话, 腾讯联合浙大开源💡 项目简介用人话介绍:给一张图片,给一段音频,它会根据音频内容让图片转成视频,并配合音频自动调整嘴型以及面部表情。转载自B站十字鱼:点击观看视频官方项目地址:https://github.com/jixiaozhong/Sonic✨ 本站优化内容针对原版进行了以下“负优化”(优化):体积瘦身:减肥 2GB界面汉化:全中文界面体验精简页面:删除了页面多余的示例目录优化:优化了文件目录,看起来更清爽性能提升:增加了显存回收功能🖼️ 效果展示效果图完整界面📥 下载链接百度网盘:https://pan.baidu.com/s/1G1Hl3DFqJq8ObnA2ujNRbQ?pwd=gpcb



网站版权本人所有,你要有本事,盗版不究。 sam@gpcb.net