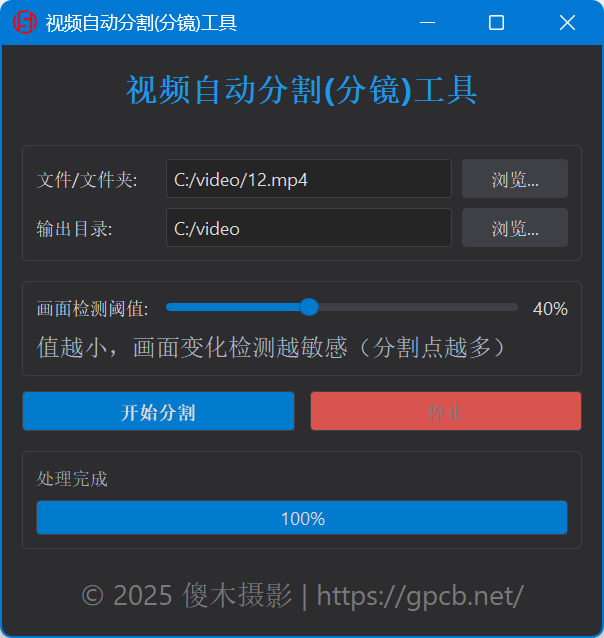
视频自动分割分镜工具
# 视频自动分割分镜工具 这是一款名为“视频自动分割(分镜)工具”的桌面应用程序,基于 Python 和 PyQt5 开发。 ### 核心功能 * **自动分割**:通过检测画面变化,自动分割视频文件...
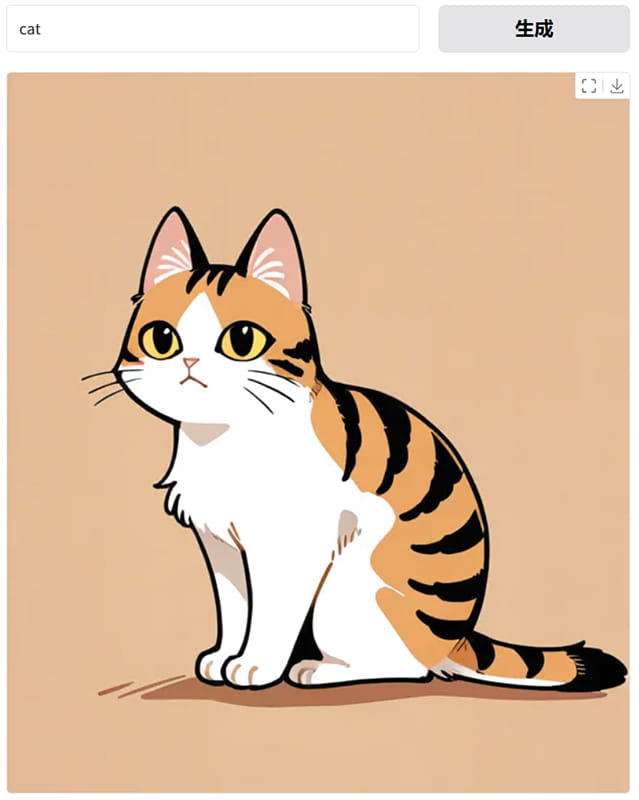
waiNSFWIllustrious_AI生成动漫图片整合包,12G英伟达显卡即可愉快玩耍
### 显存需求 * **初始化模型载入**:需要 8GB 显存 * **运行状态**(分解关键词等子模型运行后):总共约需 12GB 显存 ### 工具简介 本工具主要用来生成动漫效果。 **使用方...

IndexTTS: 可控高效语音合成系统,一键懒人包,自媒体配音神器
# IndexTTS: 可控高效语音合成系统,一键懒人包,自媒体配音神器 之前测试过好几个类似的软件,都没有这个好。可以听听下面这段音频,停顿以及语气,是不是与原装无异? /usr/uploads/2...
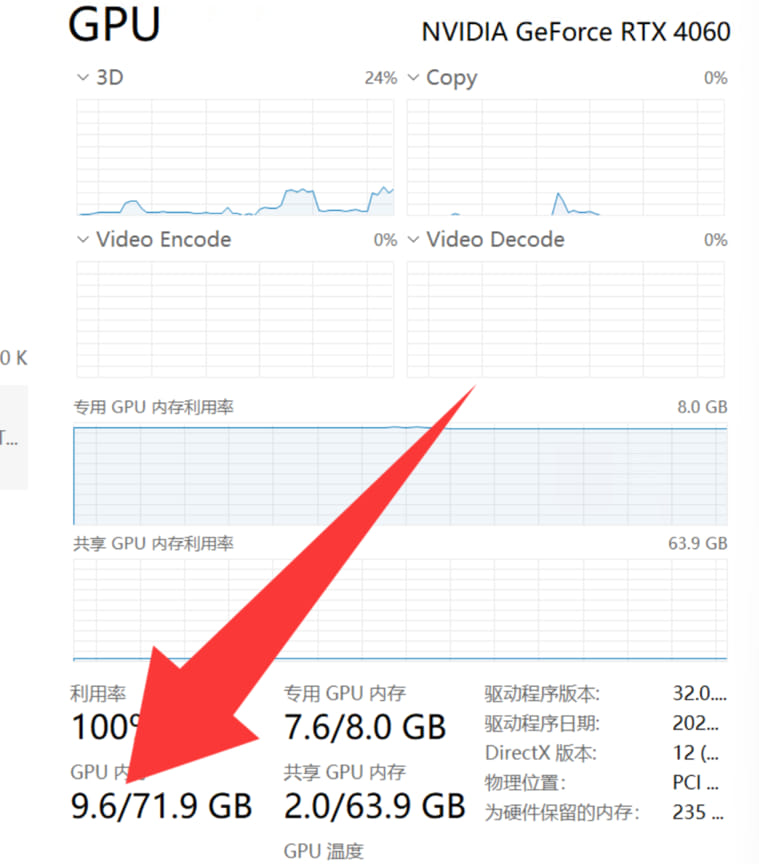
DeepSeek本地部署一键运行DeepSeek-tool v10+Qwen3-30B-A3B
# DeepSeek本地部署一键运行DeepSeek-tool v10+Qwen3-30B-A3B Qwen3前几天发布了,群里打包了懒人包。升级了llama,我替换了模型。 ### 硬件与模型配置 ...

Spark-TTS,极简版音频克隆
# Spark-TTS:极简版音频克隆 ### 核心功能 如果你是播客主,或者经常在 B 站发布视频解说,可以使用这款工具: * **音色克隆**:录制一段你说话的录音,即可用你的音色生成任意文本的音...

FunASR-webui,音频转成文本
# FunASR-webui 用于将音频转成文本,例如会议录音转成文字记录、mp4视频文件转换成字幕文件等等。 ### 运行说明 2月21更新](/usr/uploads/2025/02/2235263840.jpg)
Deepseek本地部署(内置32B和14B模型)2月21更新
首次使用需要联网下载 `install open-webui` 组件(过程是自动的),之后就不用联网了。 ### 资源信息 * **DeepSeek 本地部署**:由剑二十七制作分享 * **更新地址...

Sonic,一键包,数字人工具,音频驱动图片说话,腾讯联合浙大开源
# Sonic:腾讯联合浙大开源,一键包数字人工具 **关键词**:Sonic, 一键包, 数字人工具, 音频驱动图片说话, 腾讯联合浙大开源 --- ### 💡 项目简介 **用人话介绍:** 给一...

多任务定时执行工具
# 多任务定时执行工具 这几天写了个 PHP 中间件,用来扫描 ERP 数据库数据,定时发送到企业微信群里。由于没有找到符合要求的定时执行程序,就自己写了一个。 ### 工具特点 * **使用简单**...

图片文件自动命名工具
# 图片文件自动命名工具 ### 开发背景 这几天帮老板扫描旧照片,大约有千张之多。普通扫描仪一次能扫5张,后续 PS 裁剪成单张。输出时我录制了一个脚本,自动输出到指定的文件夹,但这会带来一个后果:...

iStoreOS 路由器设置备忘
# iStoreOS 路由器设置备忘 最近在折腾 iStoreOS 系统。这是一个开源的路由器系统,功能强大。我安装在京东 AX1800 pro 上,可能是硬件原因,自带的 app 很多装不上,能装上...

图片批量加logo
# 图片批量加 Logo 下午看我们公司的图片循环播放的,似乎是一张张插入 PPT 加的 logo 抬头,这也…… 晚上写个小工具: ### 功能特性 * **加载 Logo**:选择用于叠加的 Lo...

Clarity-Refiners-UI,图像增强,懒人包
# Clarity-Refiners-UI:图像增强与超分辨率重绘工具 用于图像增强,可以理解为将模糊的图片变清晰,将图像重绘放大超分。 ### 🚀 项目简介 **Pinokiofactory/Cla...

Diffusers-Image-Community,AI扩图,新版懒人包
AI扩图的使用非常简单,已经将原界面尽量简化了,就不做过多介绍了。 实在不懂,自己去看原作者刘锐视频讲解。我有B站账号,但是转正还得做很多题,还是免了。 **资源来源** * 转载自刘锐博客:[htt...

开源CAD_FreeCAD,网盘下载
# FreeCAD 简介 FreeCAD 是一个基于 OpenCASCADE 的开源 CAD/CAE 工具。 OpenCASCADE 是一套开源的 CAD/CAM/CAE 几何模型核心,源自法国 Ma...

OmniGen,AI文生图,图生图,身份保留,懒人包
# OmniGen:AI 文生图、图生图、身份保留懒人包 ### 核心功能 * **多图融合**:你可以上传一到三张参考图片,并根据参考图片进行融合。 * **身份保留**:你可以上传一张照片,让模型...

热门文章

最新回复
-
这个工具非常有用,感谢大佬!
 2026-11-08
-
这就弃用了啊,还想试试的
2026-11-08
-
52过来的,52有时候是有点恶心
2026-11-08
-
看看2026-11-07
-
感谢分享!下载来试下,从52过来看看2026-11-07